
Google Harness²: Selbstverbessernde Agenten lokal testen
Die lokale Harness²-Demo ausführen, Änderungen prüfen und einen kontrollierten Verbesserungsprozess für Microsoft-Foundry-Agenten entwerfen.
Googles Harness² wirft eine interessante technische Frage auf: Was passiert, wenn ein Agent den Code und die Anweisungen rund um sein Modell verbessert, während das Modell selbst gleich bleibt?
Ich habe mit der lokalen Demo angefangen. Sie ist klein genug, um Eingaben, Änderungen und Ergebnisse einzeln nachzuvollziehen. Hier zeige ich den reproduzierbaren Lauf und wie ich den Ansatz in einen kontrollierten Microsoft-Foundry-Prozess übertragen würde.
Der beschriebene Test stammt vom 20. Oktober 2026. Er verwendet programmierte Editoren und führt keine Modell-API-Aufrufe aus. Das ist für die Einordnung des Ergebnisses wichtig.
Was Harness² verändert
Ein Harness ist die Software um das Modell: Anweisungen, Tool-Schnittstellen, Arbeitskontext und Ausführungslogik. Harness² untersucht Änderungen an diesem Umfeld. Das Paper unterscheidet die Verbesserung für eine einzelne Aufgabe von Erfahrungen, die bei späteren Aufgaben wiederverwendet werden. Die Modellgewichte werden dabei nicht aktualisiert. Harness²-Paper
Bei einem Helpdesk-Agenten könnte eine solche Änderung eine unklare Tool-Beschreibung ersetzen, eine Quellenprüfung ergänzen oder ein Skript korrigieren. Das Ergebnis kann sich verändern, obwohl weiterhin dasselbe Modell-Deployment antwortet.
Deshalb würde ich mehr als den Prompt versionieren: Modell, Tool-Schemas, Retrieval-Konfiguration, Code-Revision und Testdaten gehören für mich in denselben Release-Nachweis. Sonst können zwei sehr unterschiedliche Systeme unter demselben Agentennamen laufen.
Das Repository bietet parallele und sequenzielle Verbesserungsmodi. Parallel werden Alternativen untersucht, sequenziell werden Änderungen über mehrere Schritte weitergetragen. Keiner der beiden Begriffe garantiert, dass eine übernommene Änderung auch in einem anderen Geschäftsprozess funktioniert. Experiment-Anleitung
Die lokale Demo mit festem Stand ausführen
Verwende ein eigenes Arbeitsverzeichnis und Python 3.13. Diese Befehle starten die lokale Demo, nicht die kostenpflichtigen Benchmark-Läufe:
git clone https://github.com/google-research/harness2.git
cd harness2
git checkout 1cfe254e8d25b15f37048c3730134686abe60335
python3.13 -m venv .venv
.venv/bin/python -m harness2.cli.demo --output runs/local-check --k 2
Der geprüfte Lauf endete mit:
Local demo: 2 tasks completed; 0 failed.Die Demo führt echten Python-Code aus, verwendet aber einen programmierten Editor und eine programmierte Auswahl. Zugangsdaten für ein Modell sind nicht erforderlich. Die vollständigen Benchmarks haben andere Voraussetzungen und können Cloud-Kosten verursachen. Dafür gilt die separate Setup-Anleitung.
Die feste Revision macht den Test später nachvollziehbar. Wenn du einen neueren Stand ausprobierst, notiere dessen Commit und verwende ein neues Ausgabeverzeichnis. Vermischte Artefakte erschweren sonst den Vergleich.
Die Berechnung prüfen, bevor du der Zusammenfassung vertraust
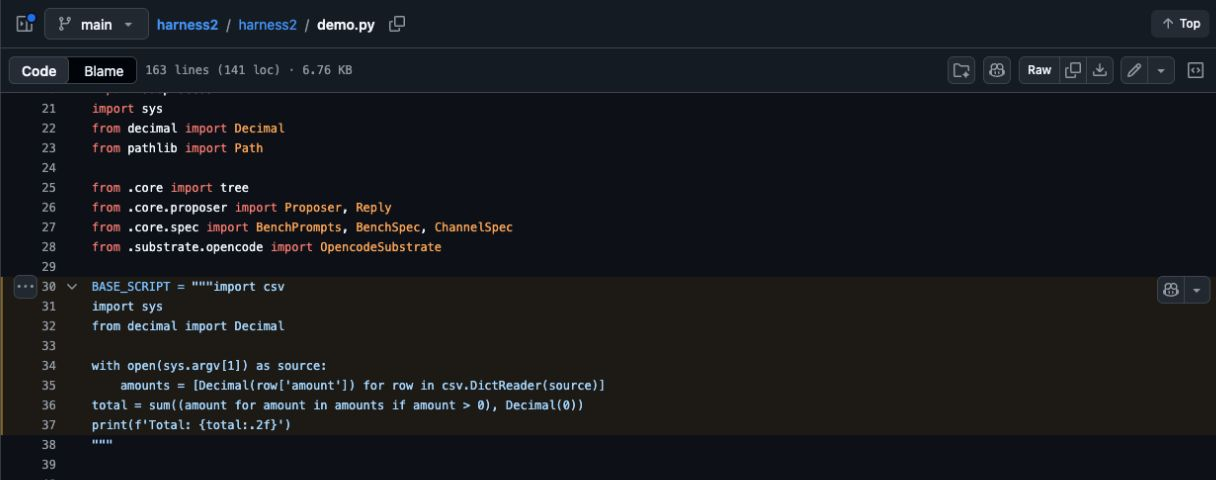
Das Beispiel enthält zwei kleine Listen mit positiven und negativen Beträgen. Das ursprüngliche Skript addiert nur positive Werte. Die programmierte Verbesserung entfernt diesen Filter.
Bei der ersten Liste lässt sich das Ergebnis ohne KI-Bewertung nachrechnen:
| Nachweis | Wert |
|---|---|
| Eingaben | 100,25; −20,10; 5,00 |
| Summe des ursprünglichen Skripts | 105,25 |
| Summe einschließlich des negativen Betrags | 85,15 |
Öffne die CSV-Datei, das ursprüngliche Skript und das erzeugte Skript. Vergleiche anschließend die gespeicherten Ergebnisse. Eine Erfolgsmeldung wird erst aussagekräftig, wenn du den korrigierten Fehler nachvollziehen kannst.
In der erzeugten demo.json standen außerdem diese Werte:
{
  "n_tasks": 2,
  "done": 2,
  "failed": 0,
  "execution_count": 28,
  "editor_calls": 32
}
Das sind lokale Ausführungen und Aufrufe des programmierten Editors. Es sind keine 28 Modellaufrufe, keine Qualitätsquote und kein gemessener Produktivitätsgewinn. Die Demo zeigt den Verbesserungsablauf. Sie belegt nicht, dass ein Modell den Fehler selbstständig entdeckt hat.
Auch in der aktuellen Reddit-Diskussion lohnt diese Nachfrage: Bedeutet „selbstverbessernd“ einen anderen Prompt, ein repariertes Tool oder neue Modellgewichte? Und was davon wurde tatsächlich getestet?
Änderung vorschlagen und Änderung übernehmen trennen
Bei einem Unternehmens-Agenten würde ich den Verbesserungsprozess von der Produktionsfreigabe trennen. Ein Kandidat muss zuerst Aufgaben bestehen, die er nicht beim Vorschlagen seiner Änderung gesehen hat.
Für einen Richtlinien-Assistenten würde ich mit diesen Fällen anfangen:
- Eine Frage mit einer eindeutigen, aktuellen Quelle.
- Eine Frage, deren Quelle gestern ersetzt wurde.
- Eine Anfrage nach einem Dokument ohne Zugriffsrecht.
- Ein Tool-Timeout ohne verlässliches Ergebnis.
- Eine plausible Frage, die die vorhandenen Quellen nicht beantworten können.
Der Kandidat muss Zugriffsgrenzen einhalten und fehlendes Wissen erkennen. Bessere Antworten auf einfache Fragen reichen nicht. Zusätzlich würde ich Aufrufe, Eingabegröße und Laufzeit vergleichen. Ein aufwendigerer Harness kann eine Antwort verbessern und den vorgesehenen Betrieb trotzdem zu teuer machen.
Die Abnahmeregel gehört außerhalb der Dateien, die der Kandidat verändern darf. Speichere Ausgangsversion, Kandidat, Testdatenstand, Fehler und Freigabeentscheidung zusammen. Kann der Agent seine eigenen Erfolgskriterien unbemerkt ändern, hilft der grüne Bericht wenig.
Foundry für die Prüfung und einen normalen Release nutzen
Foundry Insights ist eine separate Microsoft-Funktion in Public Preview. Sie kann wiederkehrendes Verhalten in Traces zusammenfassen und Maßnahmen vorschlagen. Sie ist keine native Harness²-Integration und bestätigt nicht automatisch die Richtigkeit eines Vorschlags. Insights-Dokumentation
Ich würde daraus einen überschaubaren Ablauf machen:
- Repräsentative Traces mit eindeutiger Agenten- und Versionskennung sammeln.
- Einen beobachteten Fehler auswählen, etwa wiederholtes Retrieval nach einem leeren Ergebnis.
- Einen Entwicklungs-Agenten eine kleine Änderung in einem Branch vorschlagen lassen.
- Den festen Testsatz ausführen und Fehler, Kosten sowie Zugriffsverhalten prüfen.
- Den Kandidaten über den vorhandenen Deployment-Prozess freigeben.
Dafür genügen zunächst Versionsverwaltung und Tests. Ein Agent muss keine Produktions-Prompts selbstständig verändern dürfen, damit sein Verbesserungsvorschlag nützlich ist.
Die Foundry-Evaluierungsanleitung behandelt die Tests. Der Observability-Beitrag erklärt die Ausführungsnachweise. Diese Aufgaben würde ich auch bei einer automatisierten Verbesserung getrennt sichtbar halten.
Was ich vor einem Pilot verlangen würde
Beginne mit einer lesenden Aufgabe und einem festen Kostenrahmen. Lege Verantwortlichen und Enddatum fest. Verwende synthetische oder freigegebene Testdaten und speichere genug Artefakte, um die Entscheidung später nachzuvollziehen, ohne unnötige Kundendaten aufzubewahren.
Vor einer Übernahme möchte ich aus den Dateien vier Dinge erkennen: Was wurde geändert? Welche unbekannten Testfälle wurden besser? Welche wurden schlechter? Wie stelle ich die vorige Version wieder her?
Die lokale Rechenaufgabe ist dafür ein guter Einstieg, weil sich das Ergebnis unabhängig prüfen lässt. Danach würde ich einen echten Fehler des eigenen Agenten auswählen und den Abnahmetest genauso konkret machen.
Neue Artikel direkt in dein Postfach.
Praktische Anleitungen zu Intune, KI und Azure.