
Foundry Routines: Agenten planen, doppelte Arbeit stoppen
Foundry Routines vorbereiten, Identität und Zeitzone festlegen und doppelte Jobs abfangen. Mit lokal getestetem Ledger und Abnahmeplan für Reports.
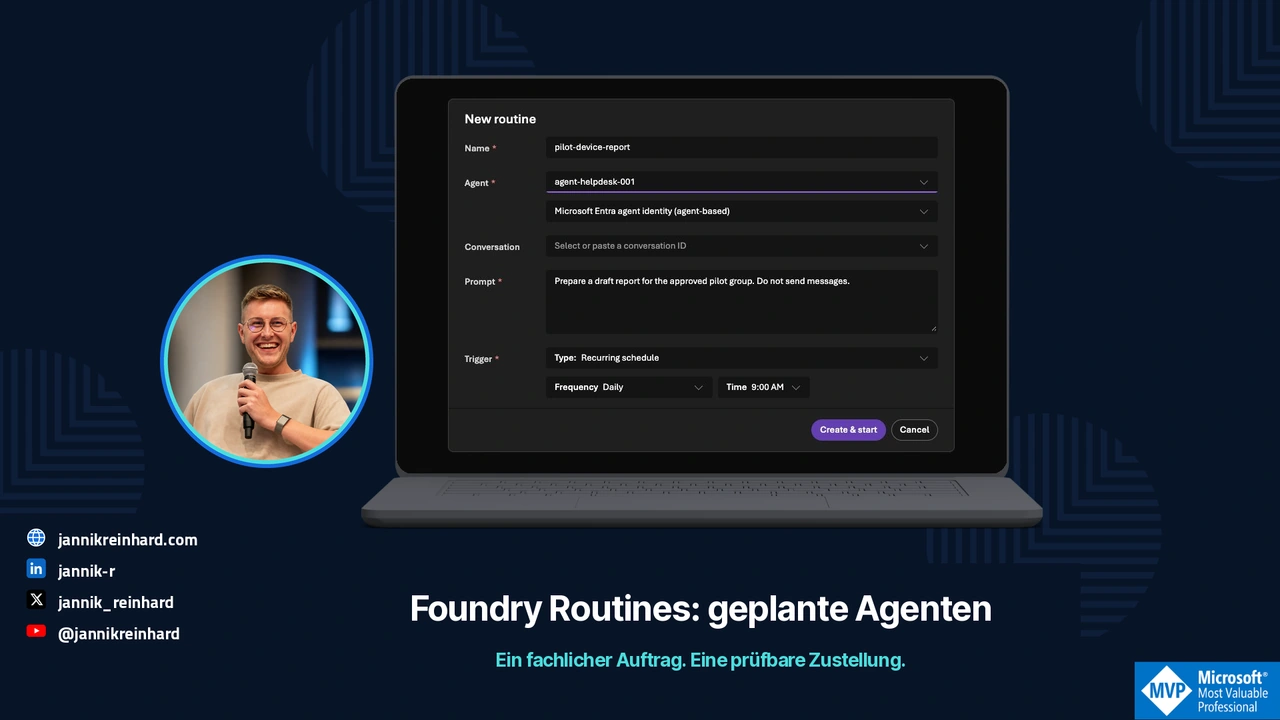
Am Montagmorgen kommt derselbe Bericht zweimal an. Beide Nachrichten sind fachlich richtig. Trotzdem ist die Automatisierung fehlgeschlagen: Jemand muss jetzt prüfen, ob die zweite Nachricht neue Arbeit enthält.
Foundry Routines vereinfachen den geplanten Start eines Agenten. Rund um den Zeitplan braucht es weiterhin eine Auftragskennung, klare Zugriffsrechte und einen Zustellnachweis. Ich würde das zuerst mit einem kleinen lesenden Bericht aufbauen, bevor ein geplanter Agent Geräte verändert oder Kunden anschreibt.
Diese Anleitung verbindet den aktuellen Routines-Einrichtungsweg mit einem lokal getesteten SQLite-Beispiel. Die Azure-Konfiguration ist vorbereitet, aber nicht in meinem Tenant aktiviert. Die Quellen wurden am 20. Oktober 2026 geprüft.
Festlegen, was die Routine starten soll
Routines sind seit dem September-Release von Foundry allgemein verfügbar. Sie können einen Agenten über Zeitplan, Timer oder ein unterstütztes Ereignis starten. Das Reminder-Tool, mit dem ein Agent sich selbst einen späteren Aufruf plant, ist eine separate Preview-Funktion. Release-Hinweis
Mein Beispiel ist ein täglicher Bericht für eine Intune-Pilotgruppe. Der Agent liest die erlaubten Daten, erstellt einen Entwurf und hält Lücken fest. Das Versenden bleibt eine eigene Entscheidung.
Drei Kennungen würde ich getrennt führen:
| Datensatz | Beispiel | Zweck |
|---|---|---|
| Routine-Dispatch | Von der Plattform vergebene ID | Einzelnen Aufruf und seine Telemetrie finden |
| Fachlicher Auftrag | pilot:2026-10-20:report-v1 |
Dieselbe Arbeit nach einem Retry wiedererkennen |
| Zustellung | Ziel und Nachrichten- beziehungsweise Bestätigungs-ID | Nachweisen, ob dieser Bericht gesendet wurde |
Eine neue Dispatch-ID bedeutet nicht zwangsläufig neue fachliche Arbeit. Umgekehrt darf der heutige Bericht nicht mit dem Schlüssel von gestern unterdrückt werden.
Einen ausgeschalteten Zeitplan vorbereiten und die Identität prüfen
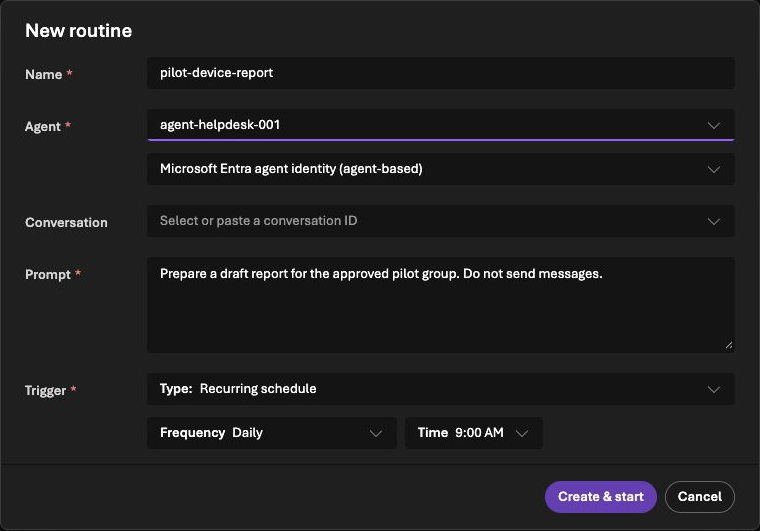
Zu den dokumentierten Voraussetzungen gehören ein bereitgestellter Prompt- oder Hosted Agent und die passende Projektrolle. Prüfe außerdem aktuelle Regionen und Verschlüsselungsanforderungen. Workflow Agents sind kein unterstütztes Ziel; Anforderungen an kundenseitig verwaltete Schlüssel brauchen besondere Beachtung. Routines-Voraussetzungen
Mit der Routines-Erweiterung der Azure Developer CLI lässt sich dieses Manifest vorbereiten:
name: pilot-device-report
description: Prepare a read-only pilot report for review.
enabled: false
triggers:
  weekday-morning:
    type: schedule
    cron: "0 8 * * 1-5"
    time_zone: Europe/Berlin
action:
  type: invoke_agent_responses_api
  agent_name: pilot-report-agent
  input: Prepare a draft report for the approved pilot group. Do not send messages.
Speichere es als routine.yaml. Nach Prüfung des Zielprojekts und des Agenten lautet der dokumentierte Erstellungsaufruf:
azd extension install azure.ai.routines
azd ai routine create --file routine.yaml
Wenn du diesen Befehl ausführst, wird eine Cloud-Ressource angelegt. Lass enabled: false bestehen, bis die Abnahme erfolgreich ist. Kontrolliere gespeicherten Zeitplan und Zeitzone im Portal. Ein kopierter UTC-Zeitplan kann nach der Zeitumstellung zur falschen lokalen Geschäftszeit laufen.
Im Manifest heißt das Feld cron, in REST und SDK dagegen cron_expression. Vermische die Formate nicht. Die aktuelle Routines-Anleitung zeigt den passenden Weg pro Client.
Standardmäßig verwendet der Dispatch die Agentenidentität. Für delegierte Tools kann bei der Erstellung ausdrücklich die Creator-Identität gewählt werden. Damit ist der Ersteller der Routine gemeint, nicht ein späterer Bearbeiter. Die Anmeldung des Event-Connectors ist eine weitere Identität. Halte diese Zuordnung fest, bevor der geplante Agent Zugriff erhält. Routine-Authorization-Modell
Den fachlichen Auftrag idempotent behandeln
Idempotent bedeutet hier: Dieselbe Anfrage darf ihren Effekt nicht erneut auslösen. Verteilte Worker können Arbeit mehrfach erhalten. Die Verarbeitung muss deshalb einen bereits bekannten Auftrag erkennen. Competing-Consumers-Muster
Dieses lokale Beispiel verwendet einen eindeutigen Schlüssel und einen Hash der Eingabe. Speichere es als job_check.py und starte python3 job_check.py:
import hashlib
import json
import sqlite3
import tempfile
from contextlib import closing
from pathlib import Path

def accept(path, key, payload):
    digest = hashlib.sha256(json.dumps(payload, sort_keys=True).encode()).hexdigest()
    with closing(sqlite3.connect(path)) as db, db:
        db.execute("CREATE TABLE IF NOT EXISTS jobs (key TEXT PRIMARY KEY, digest TEXT, state TEXT)")
        db.execute("BEGIN IMMEDIATE")
        row = db.execute("SELECT digest FROM jobs WHERE key=?", (key,)).fetchone()
        if row:
            if row[0] != digest:
                raise ValueError("same job key with changed inputs")
            return False
        db.execute("INSERT INTO jobs VALUES (?, ?, 'accepted')", (key, digest))
        return True

with tempfile.TemporaryDirectory() as folder:
    path = Path(folder) / "jobs.db"
    job = "pilot:2026-10-20:report-v1"
    payload = {"group": "pilot", "window": "2026-10-20"}
    print(accept(path, job, payload))
    print(accept(path, job, payload))
Die Ausgabe ist zuerst True, danach False. Der zweite Aufruf bezeichnet denselben Auftrag und wird nicht erneut angenommen. Derselbe Schlüssel mit veränderter Eingabe löst einen Fehler aus, statt ein unpassendes altes Ergebnis zurückzugeben.
Erzeuge den fachlichen Schlüssel aus vertrauenswürdigen Daten des Schedulers oder der Anwendung. Lass nicht das Sprachmodell die Kennung erfinden, die Mehrfachausführungen verhindern soll. Eine Produktionsdatenbank muss dieselben Eindeutigkeits- und Transaktionseigenschaften erhalten. Lege außerdem fest, wie lange abgeschlossene Schlüssel gültig bleiben.
Zustellung als eigenen Vorgang behandeln
Für den Bericht würde ich diese anwendungseigenen Zustände verwenden:
accepted → running → ready → sending → delivered
                                ↘ uncertain
Das sind vorgeschlagene Zustände der Anwendung, keine nativen Foundry-Run-Statuswerte. Nimmt der Nachrichtendienst den Bericht an und bricht danach die Verbindung ab, ist die Zustellung unklar. Den Bericht würde ich dann nicht blind erneut senden.
Speichere Bericht und ausstehende Zustellung gemeinsam. Eine Transactional Outbox ist ein möglicher Weg, den Übergang zwischen gespeichertem Ergebnis und Versandauftrag abzusichern. Idempotente Empfänger und ein passender Zustellnachweis bleiben trotzdem erforderlich. Transactional-Outbox-Muster
In meinen lokalen Tests haben zwanzig konkurrierende Annahmeversuche genau einen Auftrag angelegt. Die Zustandsprüfungen verhinderten außerdem eine zweite Übernahme und die Wiederholung einer unklaren Zustellung. Das beweist keine Exactly-once-Zustellung in Teams oder E-Mail. Diese Ziele brauchen eigene Bestätigungs- und Retry-Prüfungen.
Fehler prüfen, bevor der Zeitplan startet
| Eingebauter Fehler | Erwarteter Nachweis |
|---|---|
| Derselbe Auftrag startet zweimal | Genau ein angenommener fachlicher Auftrag |
| Quellenabfrage schlägt fehl | Entwurf nennt Datenlücke statt einen vollständigen Bericht zu erfinden |
| Ersteller verliert nötigen Zugriff | Sichtbarer Fehler mit Verantwortlichem |
| Worker startet nach dem Speichern neu | Vorhandenes Ergebnis wird gefunden, nicht still erneut erzeugt |
| Versandbestätigung geht verloren | Unklarer Zustand mit bewusstem Abgleich |
| Eingabe ändert sich bei gleichem Schlüssel | Konflikt statt falscher Erfolgsmeldung |
Ein abgeschlossener Routine-Lauf kann bedeuten, dass die nachgelagerte API den Dispatch angenommen hat, während der Agent im Hintergrund noch arbeitet. Prüfe Plattform-Lauf und fachliches Ergebnis, bevor du den Ablauf als erfolgreich abnimmst. Dispatch- und Retry-Verhalten
Nutze für den ersten Cloud-Test den dokumentierten manuellen Dispatch ohne externen Versand. Prüfe Entwurf, Quellen, Auftragskennung und Trace. Der wiederkehrende Zeitplan wird erst aktiviert, wenn dieser Weg funktioniert und der Verantwortliche den Umfang freigegeben hat.
Dasselbe Vorgehen passt zu einem Intune-Reporting-Prozess. Ob dafür ein Agent nötig ist, hängt vom Nutzen der Interpretation ab. Für eine feste Abfrage mit Tabelle würde ich eine einfache deterministische Automatisierung behalten.
Neue Artikel direkt in dein Postfach.
Praktische Anleitungen zu Intune, KI und Azure.