
Foundry IQ Deep Dive: Wissensdatenbanken für KI-Agenten
Ich zeige Foundry IQ als Wissensschicht in Microsoft Foundry: wie Knowledge Bases und Agentic Retrieval funktionieren, wie du sie per MCP mit einem…
Jedes Team, das KI-Agenten aufbaut, baut am Ende dasselbe auf: eine Retrieval-Pipeline, die Unternehmenswissen in den Agenten einspeist. Und die meisten dieser Pipelines werden immer wieder neu gebaut, pro Agent, pro Projekt. Foundry IQ ist Microsofts Antwort auf dieses Problem – eine gemeinsame Wissensschicht in Microsoft Foundry, in die sich eine beliebige Anzahl von Agenten einbinden lässt. In diesem Blogbeitrag erkläre ich, wie Foundry IQ unter der Haube funktioniert, wie Sie eine Wissensdatenbank erstellen und diese mit einem Agenten verbinden und wo die Grenzen liegen. Am Ende können Sie entscheiden, ob es Ihr benutzerdefiniertes RAG-Setup ersetzen soll.
Was ist Foundry IQ?
Foundry IQ wurde auf der Ignite 2025 zusammen mit der Umbenennung von Azure AI Foundry in Microsoft Foundry angekündigt. Die offizielle Definition ist eine „verwaltete Wissensschicht, die Unternehmensdaten in wiederverwendbare, berechtigungsbewusste Wissensdatenbanken für KI-Agenten umwandelt.“
Die Bausteine sind einfach:
– Eine Wissensquelle ist eine Verbindung zu Daten – einem Blob-Container, einer Website, einer SharePoint-Site, einem Fabric Lakehouse.
- Eine Wissensdatenbank bündelt eine oder mehrere Wissensquellen sowie die Parameter, die den Abruf steuern.
- Agenten fragen die Wissensdatenbank durch Agentenabruf ab, und mehrere Agenten können dieselbe Wissensdatenbank gemeinsam nutzen.
Eine wichtige Sache, die Sie verstehen sollten: Foundry IQ basiert auf Azure AI Search. Die Wissensdatenbank ist ein Objekt, das von Ihrem Suchdienst lebt. Sie müssen sich also nicht zwischen Foundry IQ und Azure AI Search entscheiden – Foundry IQ ist die neue Eingangstür dazu.
Hinweis: Microsoft liefert drei „IQs“ aus: Work IQ (Microsoft 365-Signale), Fabric IQ (semantische Datenschicht) und Foundry IQ (Unternehmensdaten für Agenten). Es handelt sich um separate Produkte. Copilot-Wissensquellen und Foundry IQ-Wissensquellen sind nicht austauschbar.
Welche Wissensquellen kann ich nutzen?
Es gibt zwei Klassen, und der Unterschied ist für Architekturentscheidungen von Bedeutung.
Indizierte Quellen werden in einen Suchindex für Ihren Dienst aufgenommen. Azure AI Search teilt den Inhalt in Blöcke auf, vektorisiert ihn und hält ihn mit einem Indexer-Zeitplan aktuell. Heute allgemein verfügbar: vorhandene Suchindizes, Azure Blob Storage (einschließlich ADLS Gen2), OneLake Lakehouses und Web. In der Vorschau: Azure SQL, direkter Datei-Upload und indiziertes SharePoint.
Entfernte Quellen werden überhaupt nicht aufgenommen. Sie werden zum Abrufzeitpunkt live abgefragt. Das Interessante hier ist Remote-SharePoint: Es läuft über die Copilot Retrieval API, der Inhalt verlässt SharePoint nie und SharePoint erzwingt die Benutzerberechtigungen. Der Haken: Endbenutzer benötigen eine Microsoft 365 Copilot-Lizenz. Auch remote: Fabric data agents, MCP-Server und Work IQ (alle Vorschau).
Für eine Blob-Wissensquelle generiert Azure AI Search die gesamte Aufnahmepipeline für Sie – Datenquelle, Skillset, Index und Indexer. Sie können das Einbettungsmodell (zum Beispiel text-embedding-3-large), ein Chat-Modell für die Bildverbalisierung und einen Aufnahmeplan festlegen. Dadurch allein wird eine Menge Installationscode entfernt, den ich früher von Hand geschrieben habe.
Wie funktioniert der Agentenabruf?
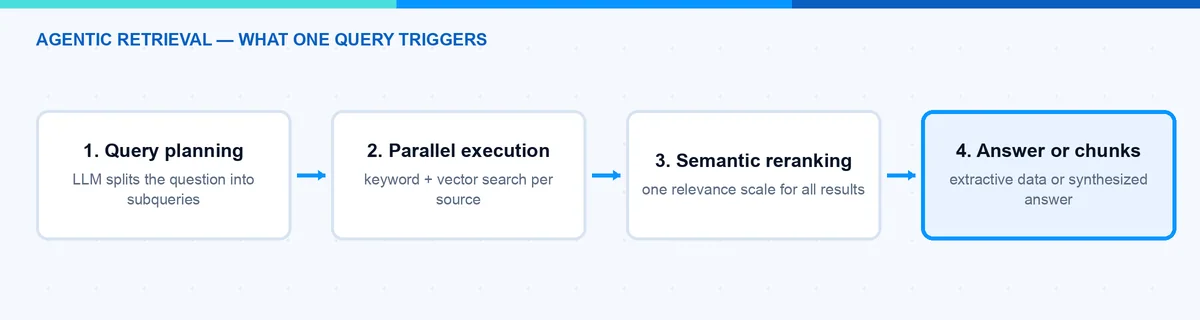
Dies ist der Teil, der Foundry IQ zu mehr als nur einer schöneren API rund um die Vektorsuche macht. Wenn ein Agent eine Frage sendet, führt die Agenten-Abruf-Engine eine kleine Pipeline aus:
- Abfrageplanung. Ein LLM unterteilt die Frage in fokussierte Unterabfragen. Es nutzt den Gesprächsverlauf, korrigiert Tippfehler und entscheidet, welche Wissensquellen abgefragt werden.
- Parallele Ausführung. Die Unterabfragen werden gleichzeitig ausgeführt, jeweils als Schlüsselwort-, Vektor- oder Hybridsuche.
- Semantisches Reranking. Jeder Ergebnissatz durchläuft den semantischen Ranking, sodass Ergebnisse aus verschiedenen Quellen auf einer Relevanzskala landen.
- Ausgabe. Sie erhalten entweder die neu eingestuften Blöcke mit Zitaten (extraktiver Modus) oder eine synthetisierte Antwort, die von einem LLM geschrieben wurde.
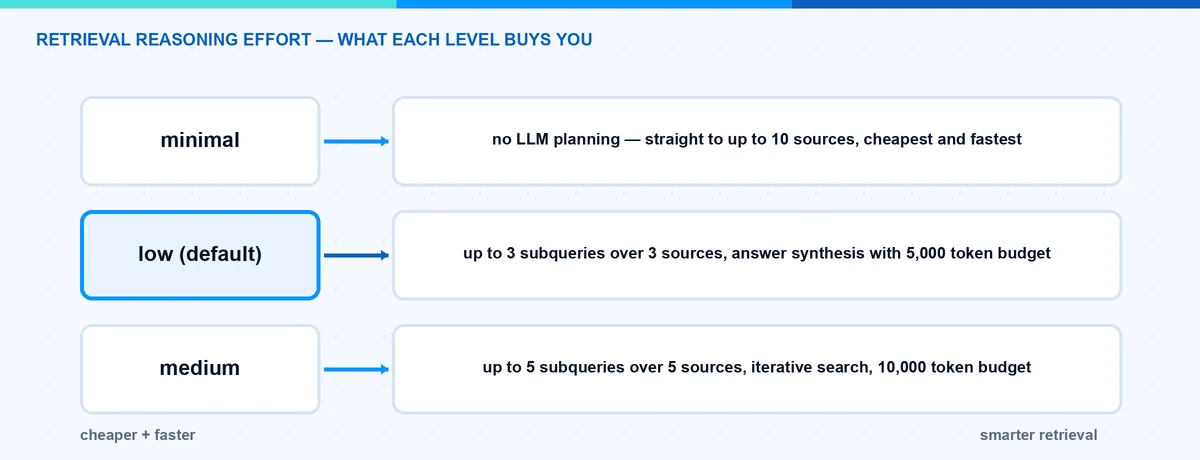
Wie viel von dieser Pipeline ausgeführt wird, wird durch den Retrieval Reasoning-Aufwand gesteuert:
- minimal – überhaupt kein LLM. Die Abfrage geht direkt an bis zu 10 Quellen. Günstigstes und schnellstes.
- Niedrig (Standardeinstellung) – bis zu 3 Unterabfragen über 3 Quellen, Antwortsynthese mit einem Budget von 5.000 Token.
- mittel – bis zu 5 Unterabfragen über 5 Quellen, plus iterative Suche: Wenn die ersten Ergebnisse schwach sind, führt die Engine Folgeabfragen aus. 10.000 Token-Budget.
Microsoft gibt an, dass die Antwortrelevanz um etwa 36 Prozent höher ist (https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/foundry-iq-boost-response-relevance-by-36-with-agentic-retrieval/4470720) als bei Single-Shot-RAG. Das ist ein Anbieter-Benchmark, also gehen Sie vorsichtig damit um – aber die Richtung stimmt mit meiner Erfahrung überein: Mehrfachabfragen plus Reranking schlagen fast immer dann eine Vektorsuche, wenn die Frage nicht trivial ist.
Wie erstelle ich eine Wissensdatenbank?
Die Wissensdatenbank wird auf dem Suchdienst erstellt. Dies ist der REST-Aufruf mit der Vorschau-API:
PUT {search-url}/knowledgebases/intune-kb?api-version=2026-05-01-preview
{
  "name": "intune-kb",
  "retrievalInstructions": "Use the intune-docs source for device management questions.",
  "outputMode": "answerSynthesis",
  "knowledgeSources": [ { "name": "intune-docs-blob" } ],
  "models": [ { "kind": "azureOpenAI", "azureOpenAIParameters": {
      "resourceUri": "https://<aoai>.openai.azure.com",
      "deploymentId": "gpt-5-mini", "modelName": "gpt-5-mini" } } ],
  "retrievalReasoningEffort": { "kind": "low" }
}
Aufmerksamkeit verdienen die retrievalInstructions: Dieser Text steuert den Abfrageplaner bei der Entscheidung, welche Quelle verwendet werden soll. Schreiben Sie es so, als würden Sie es einem Kollegen erklären.
Hinweis: Die GA-API-Version (01.04.2026) unterstützt nur das minimale, extraktive Setup. Abfrageplanung, Antwortsynthese und Argumentationsaufwand erfordern alle die Vorschau-API. Beachten Sie dies bei Produktionsverpflichtungen.
Wie verbinde ich die Wissensdatenbank mit einem Agenten?
Das hat mich positiv überrascht: Der Integrationsmechanismus ist schlicht MCP. Jede Wissensdatenbank stellt einen MCP-Endpunkt mit genau einem Tool, knowledge_base_retrieve bereit. Im Foundry-Portal verbinden Sie es unter Build > Knowledge. Im Code sieht es so aus (vollständige Anleitung):
from azure.ai.projects.models import PromptAgentDefinition, MCPTool

mcp_kb_tool = MCPTool(
    server_label="knowledge-base",
    server_url=f"{search_endpoint}/knowledgebases/intune-kb/mcp?api-version=2026-05-01-preview",
    require_approval="never",
    allowed_tools=["knowledge_base_retrieve"],
    project_connection_id=connection_name)

agent = project_client.agents.create_version(
    agent_name="intune-assistant",
    definition=PromptAgentDefinition(
        model="gpt-5-mini",
        instructions="Answer from the knowledge base and cite sources. If nothing is found, say so.",
        tools=[mcp_kb_tool]))
Da es sich bei der Schnittstelle um Standard-MCP handelt, funktioniert die gleiche Wissensdatenbank auch mit Claude, LangChain oder jedem anderen MCP-fähigen Client. Dies ist ein echter Vorteil gegenüber den alten proprietären Tool-Integrationen.
Foundry IQ im Vergleich zur klassischen Suche Tools
Vor Foundry IQ haben Sie einen Azure AI Search Tool (ein Index, Single-Shot-Abfrage) oder die Dateisuche Tool (Vektorspeicher pro Agent) an Ihren Agent angehängt. Hier ist mein ehrlicher Vergleich:
| Option | Verwenden Sie wann | Kosten, die Sie zahlen |
|---|---|---|
| Foundry IQ Wissensdatenbank | Mehrere Quellen oder Agenten, berechtigungsbasierter Abruf | Vorschau-API für die guten Teile, mehr bewegliche Teile |
| Azure AI Search Tool | Ein Index, ein Agent, vollständige Abfragekontrolle | Sie bauen Abfragelogik und Zitate auf |
| Dateisuche Tool | Kurze Demo mit einer Handvoll Dateien | Silo pro Agent, keine Wiederverwendung |
Bei allem, was über mehr als eine Datenquelle oder mehr als einen Agenten verfügt, gewinnt die Wissensdatenbank. Die Dateisuche Tool ist jetzt selbst nur noch ein Wissensquellentyp, den Sie zu einer Wissensdatenbank zusammenfassen können – die Ihnen sagt, wohin das führt.
Was kostet es?
Zwei Zähler: Azure AI Search stellt Abruftokens für die Ausführung und Neubewertung von Unterabfragen in Rechnung, und Azure OpenAI stellt die Tokens für die Abfrageplanung und Antwortsynthese in Rechnung. Das docs-Beispiel liegt bei etwa 4,32 $ für 2.000 Abrufe – meiner Meinung nach sehr angemessen für die Leistung der Pipeline. Außerdem gibt es ein monatliches kostenloses Token-Kontingent und seit Build 2026 eine serverlose Entwicklerstufe in der Vorschau, die auf Null skaliert.
Die Kostenhebel, in der Reihenfolge ihrer Auswirkung: Argumentationsaufwand, Anzahl der Wissensquellen und das activity-Protokoll – es zeigt Ihnen genau, welche Unterabfragen ausgegeben wurden und was sie verbrauchten.
Der Ansatz, den ich tatsächlich verwende
- Beginnen Sie mit einer Blob-Wissensquelle und lassen Sie die automatisch generierte Pipeline Chunking und Vektorisierung durchführen. Bauen Sie nicht zuerst ein Skillset von Hand auf.
- Stellen Sie den Argumentationsaufwand auf minimal ein und messen Sie die Qualität mit Ihrem eigenen Evaluation-Set (ich habe mein Setup in wie man KI-Agenten in Microsoft Foundry bewertet beschrieben). Gehen Sie nur dann auf niedrig oder mittel, wenn die Zahlen dies erfordern.
- Verwenden Sie den extraktiven Modus für Agenten – die Argumentation übernimmt ohnehin das eigene Modell des Agenten. Antwortsynthese nur, wenn die Abrufausgabe direkt an Benutzer geht.
- Eine Wissensdatenbank pro Domäne, nicht pro Agent. Wiederverwendung ist der springende Punkt.
Fallstricke, die ich jetzt vermeide
- Durchführung der Sicherheit pro Benutzer durch den Agenten Tool. Das Benutzertoken wird über den Header
x-ms-query-source-authorizationübergeben, aber Foundry Agent Service wendet MCP-Header pro Agentendefinition an, nicht pro Anfrage. Für eine echte Kürzung pro Benutzer rufen Sie die Responses-API direkt auf. - Webquellen ohne Antwortsynthese. Eine Webwissensquelle erfordert das
models-Array und die Synthese – und der Abruf kann HTTP 206 zurückgeben, wenn die Zusammenfassung fehlschlägt. Behandeln Sie es. - Der automatisch generierte Index wird als bearbeitbar behandelt. Die Blob-Quelle generiert Datenquelle, Skillset, Index und Indexer aus einer festen Vorlage. Wenn Sie diese Objekte manuell bearbeiten, wird die Synchronisierung unterbrochen.
- Vergessen Sie, dass die Wissensdatenbank und ihre Quellen im selben Suchdienst vorhanden sein müssen. Planen Sie Kapazität für einen Dienst pro Domäne.
Wohin das führt
Die Rückholung wird zur Infrastruktur. Das interessante Signal ist, dass Microsoft das Ganze hinter MCP gestellt hat: Wissen ist keine plattformspezifische Funktion mehr, sondern wird zu einem Endpunkt, den jeder Agent anrufen kann – Foundry-Agenten heute, Ihre Agent Framework-Workflows morgen, Drittanbieter-Clients übermorgen. Wenn Sie Agenten auf Microsoft Foundry erstellen, würde ich jetzt aufhören, benutzerdefinierte RAG-Pipelines zu schreiben und diese Energie in gute Wissensquellen und ehrliche Evaluations stecken. Die Details finden Sie in der Foundry IQ-Dokumentation.
Ich hoffe, das hilft Ihnen, ein paar Umwege zu überspringen, die ich gemacht habe.
Bleiben Sie gesund,
Prost Jannik