
Foundry-Agent-Kosten: Token, Retries und Budget begrenzen
Foundry-Agent-Kosten mit Laufbudgets, Token-Limits und begrenzten Retries steuern. Reservierungen testen und Schätzungen von Abrechnung unterscheiden.
Ein günstiger Modellaufruf kann zu einem teuren Agentenlauf werden. Ein Tool schlägt fehl, der Agent wiederholt die Anfrage, sendet die inzwischen längere Unterhaltung erneut und lässt das Ergebnis von einem weiteren Modell prüfen.
Die aktuelle Diskussion über Kostenlimits pro KI-Nutzer bringt mich zu einer praktischen Frage: An welcher Stelle stoppt das System tatsächlich? Das würde ich klären, bevor ich über einen günstigeren Token-Preis spreche.
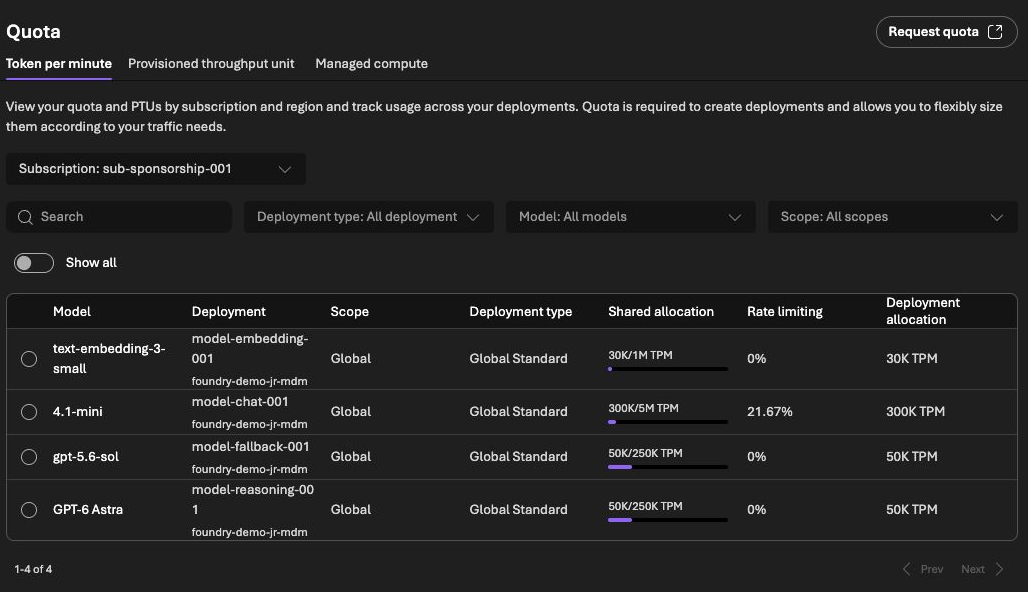
Hier trenne ich Azure-Kostenwarnungen, Token-Quoten am Gateway und die Freigabe einzelner Aufrufe in der Anwendung. Das lokale Beispiel verwendet fiktive Beträge und keine Modellaufrufe. Die Produktangaben wurden am 20. Oktober 2026 geprüft.
Die Kosten eines akzeptierten Ergebnisses messen
Beginne mit einer Einheit, die ein Mensch bewerten kann: ein richtig gelöstes Ticket, ein geprüfter Bericht oder ein verarbeitetes Dokument mit ausreichender Qualität. Eine erfolgreiche HTTP-Antwort ist dafür zu wenig.
Für einen Support-Prozess würde ich Modellnutzung, Retrieval- und Tool-Kosten, Laufzeit, Wiederholungen und Abnahmeergebnis unter einer gemeinsamen Aufgabenkennung erfassen. Auch ungelöste Aufgaben gehören in die Kostensumme.
Kosten je akzeptiertem Ergebnis =
  Kosten aller Versuche im Zeitraum / akzeptierte Ergebnisse im Zeitraum
Wenn du nur die Kosten erfolgreicher Aufrufe durch erfolgreiche Aufrufe teilst, verschwindet der Aufwand der Fehlversuche. Trenne außerdem feste Kapazitätskosten von Schätzungen einzelner Requests. Foundry kann mehrere Abrechnungskomponenten enthalten; eine Token-Schätzung ist keine vollständige Rechnung. Foundry-Kostenverwaltung
Jede Kontrolle bekommt eine klare Aufgabe
| Kontrolle | Wofür ich sie nutze | Was ich nicht voraussetzen würde |
|---|---|---|
| Azure-Cost-Management-Budget | Finanzübersicht, Prognosen und Benachrichtigungen | Sofortiges Blockieren eines Requests |
| APIM-Token-Quote | Modellverkehr über einen bestimmten Gateway-Pfad begrenzen | Exaktes Währungslimit über alle Modelle und Regionen |
| Laufbudget der Anwendung | Vor dem nächsten Schritt über dessen Freigabe entscheiden | Kontrolle über Aufrufe außerhalb der Anwendung |
| Schrittzahl und Zeitlimit | Schleifen und verlassene Aufgaben stoppen | Ersatz für tatsächliche Nutzungsmessung |
Azure-Budgets stoppen den Verbrauch nicht automatisch. Kostendaten und Budgetprüfung kommen zudem zeitversetzt an. Als letzte Prüfung vor einem teuren Aufruf eignen sie sich deshalb nicht. Die Warnung bleibt sinnvoll, braucht aber einen Verantwortlichen und einen klaren Reaktionsweg. Verhalten von Azure-Budgets
Für Foundry gibt es außerdem eine Cost-Control-CLI in Preview. Prüfe Aktion, Geltungsbereich und Durchsetzung der verwendeten API-Version. Eine gespeicherte Alert- oder Audit-Regel belegt noch kein blockierendes Limit. Cost-Control-Referenz
Budget vor dem Modellaufruf reservieren
Eine Prüfung nur gegen bereits abgeschlossenen Verbrauch übersieht parallele Requests. Zwei Worker können denselben Restbetrag sehen und beide ihre Arbeit starten.
Ich würde vor dem Aufruf einen konservativen Betrag reservieren und ihn danach mit der gemeldeten Nutzung verrechnen. In die Schätzung gehören tatsächliche Eingabe, erlaubte Ausgabelänge und aktuelle Preise der Bereitstellungsart. Tools mit eigener Abrechnung benötigen einen zusätzlichen Rahmen.
Der Kern eines lokalen Beispiels sieht so aus. Alle Beträge sind fiktive USD-Werte; die Klasse berechnet keinen Anbieterpreis:
from decimal import Decimal
from threading import Lock
from uuid import uuid4

class Budget:
    def __init__(self, limit):
        self.limit = Decimal(limit)
        if not self.limit.is_finite() or self.limit <= 0:
            raise ValueError("invalid limit")
        self.spent = Decimal("0")
        self.pending = {}
        self.halted = False
        self.lock = Lock()

    def reserve(self, amount):
        amount = Decimal(amount)
        if not amount.is_finite() or amount <= 0:
            raise ValueError("invalid reservation")
        with self.lock:
            if self.halted or self.spent + sum(self.pending.values()) + amount > self.limit:
                raise RuntimeError("stop before calling the model")
            key = str(uuid4())
            self.pending[key] = amount
            return key

    def settle(self, key, actual):
        actual = Decimal(actual)
        if not actual.is_finite() or actual < 0:
            raise ValueError("invalid cost")
        with self.lock:
            reserved = self.pending.pop(key)
            self.spent += actual
            if actual > reserved:
                self.halted = True
                raise RuntimeError("estimate exceeded; reconcile before resuming")

budget = Budget("5.00")
first = budget.reserve("2.00")
budget.reserve("2.00")
try:
    budget.reserve("2.00")
except RuntimeError:
    print("third request blocked")
budget.settle(first, "1.25")
assert budget.spent + sum(budget.pending.values()) == Decimal("3.25")
Die dritte Reservierung wird vor einem möglichen Modellaufruf abgelehnt. Die andere laufende Reservierung bleibt berücksichtigt, bis ihr Ergebnis geklärt ist. Nach einem Timeout würde ich sie nicht einfach freigeben und denselben Auftrag erneut starten, solange unklar ist, was der Anbieter bereits ausgeführt hat.
Das Lock synchronisiert nur Threads in einem Prozess. Mehrere Produktionsinstanzen benötigen einen dauerhaften, atomaren Reservierungsspeicher und einen Abgleich nach Neustarts. Das Beispiel prüft eine Freigaberegel; es garantiert kein Azure-weites Ausgabenlimit.
Den Gateway-Pfad mit einer Token-Grenze ergänzen
Ein gemeinsamer Pilot-Zähler kann in APIM so aussehen:
<llm-token-limit
  counter-key="support-pilot-v1"
  tokens-per-minute="6000"
  token-quota="60000"
  token-quota-period="Daily"
  estimate-prompt-tokens="true" />
Die Werte sind Beispiele, keine Produktionsempfehlung. Alle Requests mit diesem festen Schlüssel teilen sich denselben Zähler. Bei kundenspezifischen Grenzen muss der Schlüssel aus einer geprüften Identität oder einer vertrauenswürdigen serverseitigen Zuordnung entstehen. Ein frei wählbarer Client-Header ist dafür ungeeignet.
APIM dokumentiert unterschiedliche Antworten bei Raten- und Quotenüberschreitung, Schätzverhalten und mögliche Überläufe bei parallelen Aufrufen. Die Zähler gelten außerdem pro Gateway. Teste Streaming und Parallelität, statt daraus eine exakte Währungsgrenze abzuleiten. Token-Limit-Policy
Der AI-Gateway-Beitrag beschreibt die Routing-Schicht. Diese Kontrolle hilft nur für Aufrufe, die wirklich über das Gateway laufen.
Wiederholungen über die gesamte Aufgabe begrenzen
Drei Versuche im SDK, drei im Tool-Wrapper und drei in der äußeren Agentenschleife können bis zu 27 Versuche für eine Operation erlauben. Das ist eine beispielhafte Obergrenze. Sie zeigt aber, weshalb ich Versuche zentral zählen würde.
Prüfe vor jedem Retry verbleibende Zeit, Schrittzahl, reserviertes Budget und die sichere Wiederholbarkeit der Operation. Ein Authentifizierungsfehler benötigt eine korrigierte Konfiguration. Mehr Modellüberlegungen beheben ihn nicht. Eine dauerhaft erschöpfte Quote sollte den Lauf stoppen. Ein vorübergehender Fehler kann eine begrenzte Pause und einen weiteren Versuch rechtfertigen.
Schreibende Operationen gehören nicht in blinde Wiederholungen. Wurde ein Ticket bereits angelegt und nur die Bestätigung verloren, prüfe den Geschäftsvorgang oder einen Idempotenzschlüssel vor dem erneuten Anlegen.
Den Stopp testen, nicht nur die Warnung
In meinen lokalen Tests wurden bei einem Budget von drei Einheiten nur drei von 30 Reservierungsversuchen zugelassen. Sie liefen über einen Pool mit zehn Workern. Weitere Tests prüfen ungültige Eingaben, Abrechnung und einen unterschätzten Request, nach dem keine neue Arbeit freigegeben wird. Das sind Prüfungen des lokalen Beispiels, nicht der Anbieterabrechnung.
Vor einem Pilot würde ich zusätzlich diese Fälle durchspielen:
- Lange Eingabe mit maximal erlaubter Ausgabe.
- Mehrere gleichzeitige Requests kurz vor der Grenze.
- Tool-Timeout nach Annahme des Auftrags im Backend.
- Geschlossener Client bei weiterlaufender Verarbeitung.
- Direkter Backend-Aufruf, der das Gateway nicht umgehen darf.
- Kostenschätzung, die nicht mehr zum Bereitstellungspreis passt.
Gleiche die Schätzungen anschließend mit tatsächlichen Kostendaten ab und berücksichtige auch abgebrochene sowie erfolglose Läufe. Dann lässt sich sinnvoll über Modelle sprechen: Welche Konfiguration liefert das benötigte Ergebnis im Kostenrahmen, einschließlich der nötigen Korrekturarbeit?
Neue Artikel direkt in dein Postfach.
Praktische Anleitungen zu Intune, KI und Azure.